Raport platformy pokazuje konwersje przypisane do reklamy według określonej reguły. Test inkrementalności zadaje trudniejsze pytanie: ile z tych wyników nie wydarzyłoby się bez kampanii. Odpowiedź wymaga wiarygodnej grupy porównawczej, wspólnej definicji wyniku i dyscypliny, która chroni eksperyment przed mieszaniem ekspozycji.
Różnica jest ważna szczególnie dla marek z dużym popytem organicznym, remarketingu i kanałów docierających do osób już skłonnych do zakupu. Wysoka liczba konwersji po kontakcie nie dowodzi dodatkowego efektu. Z drugiej strony brak szybkiego kliknięcia nie oznacza braku wpływu. Eksperyment pomaga oszacować kontrfaktyczny przebieg w konkretnym czasie i populacji.
Poradnik należy do huba pomiaru i optymalizacji kampanii. Nie daje jednego projektu dla każdej platformy. Dostępne metody, minimalne budżety i zasady prywatności zmieniają się, więc konfigurację trzeba oprzeć na aktualnej dokumentacji narzędzia i wsparciu analitycznym.
Zacznij od decyzji, którą zmieni wynik testu
Dobre pytanie jest konkretne: czy kampania pozyskująca nowych klientów zwiększa liczbę pierwszych zakupów; czy reklama wideo dodaje sprzedaż ponad działający search; czy wstrzymanie remarketingu w części populacji obniża wynik. „Czy reklama działa?” jest zbyt szerokie, bo nie określa kanału, odbiorcy, okresu ani mierzonego efektu.
Przed startem należy zapisać działanie po różnych wynikach. Jeśli dodatni lift uzasadni skalowanie, trzeba określić oczekiwany koszt dodatkowej konwersji. Jeśli wynik będzie niepewny, można przedłużyć pomiar, zwiększyć skalę lub uznać, że dostępne dane nie rozstrzygają. Test bez reguły decyzji łatwo interpretuje się później pod oczekiwanie zamawiającego.
Jednostką wyniku może być zakup, przychód, marża, rejestracja lub wizyta offline. Zdarzenie musi być mierzone jednakowo w obu grupach, mieć odpowiednie okno i wystarczającą jakość. Jeżeli część sprzedaży trafia do systemu z opóźnieniem, analiza nie może kończyć się przed domknięciem danych.
Przed startem zapisz, co mogłoby unieważnić wniosek: zmiana cen, ogólnopolska promocja, migracja pomiaru, nakładanie innej kampanii, brak identyfikacji sprzedaży offline lub wyciek grup. Dla każdego ryzyka ustal monitoring.
Warto też ustalić minimalny efekt istotny biznesowo. Bardzo duży test może wykryć zmianę statystycznie wiarygodną, ale zbyt małą, by pokryć koszt kampanii. Z kolei mała próba może nie wykryć efektu, który ekonomicznie byłby ważny. Projekt powinien połączyć moc statystyczną z progiem decyzji.
Dobierz jednostkę losowania i grupę kontrolną
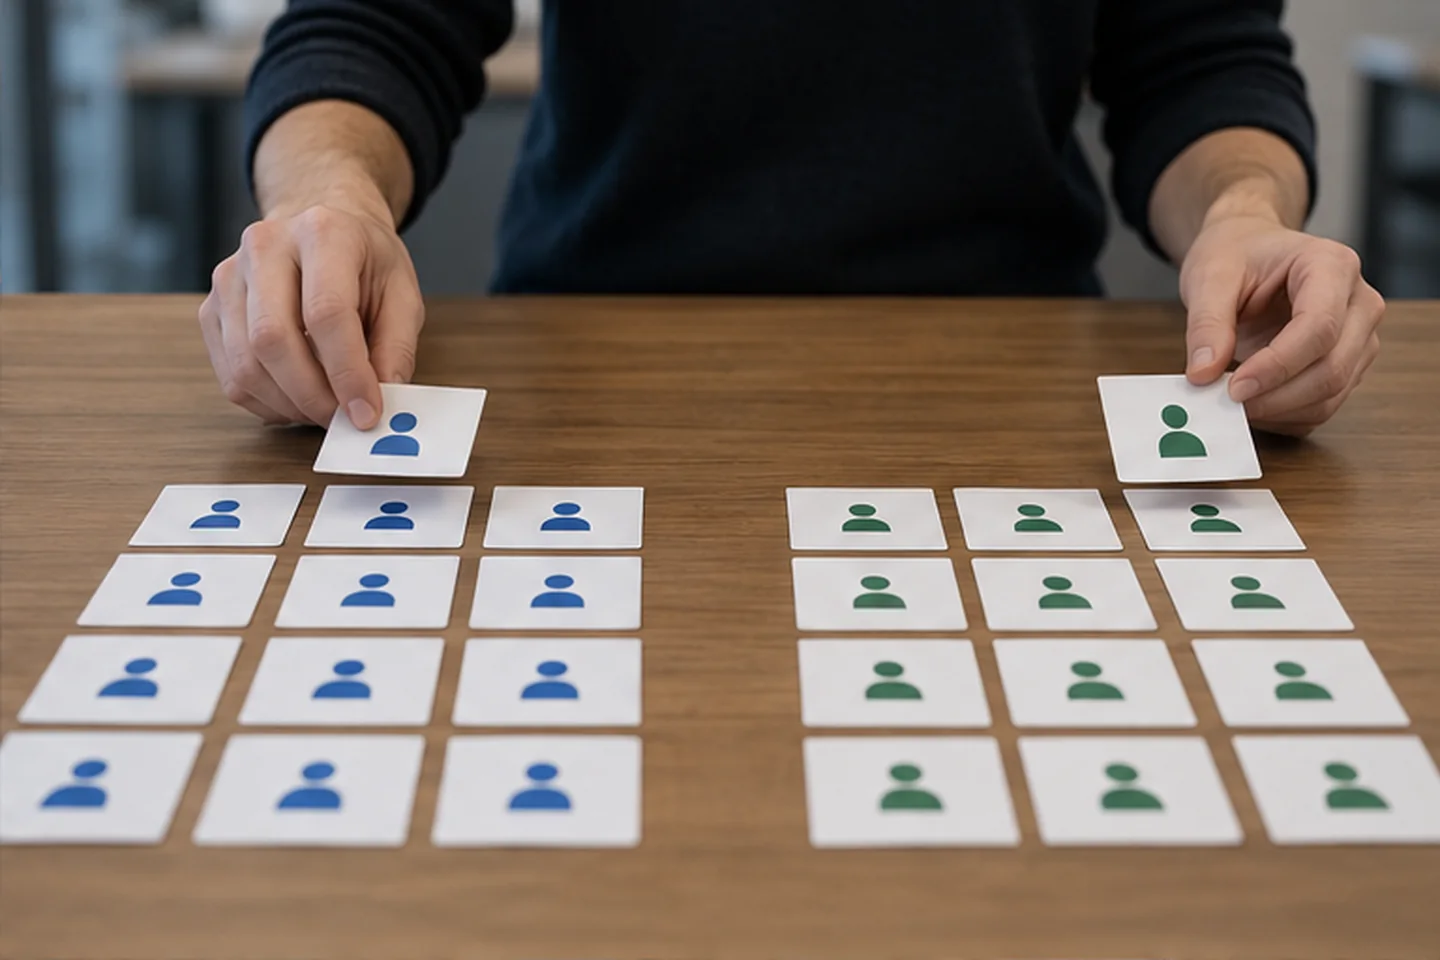
W eksperymencie użytkownikowym kwalifikująca się populacja jest losowo dzielona na grupę, która może zobaczyć reklamę, oraz grupę wstrzymaną. Randomizacja pozwala zrównoważyć cechy obserwowane i nieobserwowane w granicach próby. Trzeba jednak sprawdzić, czy ta sama osoba nie trafia do grup przez inne urządzenia, konta albo kanały.
Test geograficzny porównuje regiony lub inne obszary, w których emisja jest włączana i ograniczana. Przydaje się dla mediów trudnych do podziału użytkownikowego, kanałów offline i pomiaru łącznego. Wymaga doboru podobnych jednostek, danych historycznych i kontroli wpływu lokalnych zdarzeń. Mała liczba regionów oraz przenikanie odbiorców obniżają wiarygodność.
Wstrzymanie reklamy powinno być realne. Jeśli grupa kontrolna nadal widzi tę samą kampanię z innego konta, partnera lub kanału, różnica się zmniejszy. Nie zawsze można osiągnąć pełną izolację, ale trzeba monitorować nakładanie i uczciwie opisać, jaki efekt mierzymy: badanego zestawu kampanii przy reszcie mediów działającej, a nie całego marketingu.
| Element projektu | Decyzja przed startem | Typowe ryzyko |
|---|---|---|
| Populacja | Kto może wejść do testu i kto jest wykluczony | Mieszanie nowych i obecnych klientów |
| Losowanie | Użytkownik, konto, gospodarstwo lub geografia | Ta sama osoba w obu warunkach |
| Ekspozycja | Które kampanie są badanym pakietem | Kontrola widzi reklamę z innego źródła |
| Wynik | Zdarzenie, wartość, okno i opóźnienie | Inna kompletność danych między grupami |
Grupa kontrolna nie jest „brakiem klienta”. Osoby w niej mogą kupować dzięki potrzebie, marce, wyszukiwarce, e-mailowi i innym działaniom. Właśnie ich wynik tworzy bazę dla tego, co wydarzyłoby się bez badanej ekspozycji. Odejmowanie tej bazy od wyniku grupy eksponowanej daje szacunek dodatkowego efektu w warunkach testu.
Przed startem warto sprawdzić równowagę grup na danych historycznych, jeśli jest to możliwe, i potwierdzić brak różnicy w okresie przed testem. Nie „naprawia” to złej randomizacji, ale ujawnia problemy implementacyjne. Dla testów geograficznych okres bazowy jest szczególnie ważny przy doborze par i modelu.
Nie optymalizuj testu w sposób, który zmienia pytanie
W czasie badania kampania powinna działać w warunkach zbliżonych do planowanych po decyzji. Jeśli budżet, kreacja, cel optymalizacji lub odbiorca zmieniają się co kilka dni, wynik opisuje mieszaną interwencję. Nie każda zmiana jest zakazana, ale każda istotna musi być zapisana, a część może wymagać restartu lub osobnej interpretacji.
Platformowy algorytm optymalizuje emisję w grupie eksponowanej, więc nie każdy zakwalifikowany użytkownik zobaczy reklamę. To normalne i zależne od metodologii badania. Nie należy po fakcie analizować wyłącznie osób, które faktycznie miały kontakt, bo ekspozycja nie jest losowa. Podstawowym porównaniem pozostaje przypisanie do warunku zgodnie z projektem.
Test powinien obejmować pełny cykl tygodnia i czas potrzebny na reakcję klienta, chyba że produkt ma inny rytm. Zakończenie przy pierwszym korzystnym wyniku zwiększa ryzyko fałszywego wniosku. Długość oraz wielkość próby ustala się przed startem, a wcześniejsze zatrzymanie tylko według zaplanowanej reguły lub z przyczyn technicznych.
W trakcie monitoruje się zdrowie testu, nie szuka codziennie zwycięzcy. Należy obserwować liczebność, wydatki, działanie zdarzeń, równowagę, wyciek i nietypowe wydarzenia. Podgląd wstępnego liftu bywa kuszący, ale wynik może się zmieniać wraz z napływem danych i opóźnionymi konwersjami.
Jeśli równolegle trwa promocja, awaria serwisu lub duża kampania PR, trzeba ocenić, czy wpływa podobnie na grupy. Randomizacja chroni przed wieloma wspólnymi zdarzeniami, lecz nie przed takim, które obejmuje tylko wybrane regiony lub jest powiązane z przydziałem. Notatnik eksperymentu jest równie ważny jak końcowa tabela.
Interpretuj efekt razem z niepewnością i ekonomią
Podstawowy lift absolutny jest różnicą wyniku między grupą eksponowaną i kontrolną po właściwym przeskalowaniu. Lift względny odnosi tę różnicę do poziomu kontrolnego. Duży procent przy bardzo niskiej bazie może oznaczać niewielką liczbę dodatkowych zdarzeń, dlatego trzeba pokazywać oba ujęcia oraz wielkości grup.
Przedział niepewności mówi, jakie wartości są zgodne z danymi i metodą. „Brak istotnego wyniku” nie dowodzi braku efektu; może oznaczać zbyt małą próbę lub dużą zmienność. Trzeba sprawdzić, czy przedział wyklucza efekt istotny biznesowo. Jeśli obejmuje zarówno stratę, jak i znaczącą korzyść, uczciwym wnioskiem jest brak rozstrzygnięcia.
Dodatkowe konwersje należy zestawić z kosztem, marżą i jakością klientów. Koszt inkrementalnej konwersji może znacząco różnić się od raportowanego kosztu konwersji przypisanej. Warto również sprawdzić, czy efekt nie polega na przyspieszeniu zakupu o kilka dni bez zwiększenia wartości w dłuższym oknie.
Segmentacja po teście powinna być ostrożna. Dzielenie wyniku na wiele małych grup zwiększa ryzyko przypadkowych „odkryć” i obniża moc. Najważniejsze segmenty najlepiej zaplanować wcześniej. Wynik dla jednego wieku, regionu czy urządzenia bez odpowiedniej liczby obserwacji jest hipotezą do kolejnego badania, nie nową strategią.
Eksperyment mierzy określoną kampanię, populację, czas i warunki. Nie należy automatycznie przenosić efektu na inny sezon, budżet lub rynek. Skalowanie może zmienić częstotliwość, zasięg i krańcową jakość odbiorców. Wynik powinien zasilać prognozę scenariuszową, a nie być traktowany jako stała na zawsze.
Po zakończeniu warto zapisać pełny protokół: pytanie, projekt, daty, zmiany, wynik, niepewność, ograniczenia i decyzję. Kolejny test powinien wynikać z tej wiedzy. Seria porównywalnych eksperymentów jest cenniejsza niż jeden spektakularny wynik, którego nikt nie potrafi odtworzyć.
Test inkrementalności nie zastępuje bieżącej analityki i atrybucji. Atrybucja pomaga operacyjnie kierować kampaniami, a eksperyment kalibruje, ile wyniku jest dodatkowe. Gdy obie metody są utrzymywane w swoich rolach, zespół może optymalizować codziennie i okresowo sprawdzać, czy poprawia prawdziwy efekt.
Wynik testu musi być możliwy do połączenia z porządkiem danych kampanii. Najpierw ustal nazewnictwo i parametry UTM, a osobno zdecyduj, czy kampania wymaga także badania brand lift. Inkrementalna sprzedaż i zmiana świadomości odpowiadają na różne pytania; nie powinny być zastępowane jednym wskaźnikiem kliknięć.
Najczęstsze pytania o test inkrementalności
Czym różni się lift od konwersji przypisanych?
Konwersja przypisana spełnia regułę kontaktu i okna w raporcie. Lift szacuje różnicę względem grupy, która nie miała dostępu do badanej reklamy, czyli efekt dodatkowy w warunkach testu.
Czy brak statystycznie istotnego liftu oznacza, że reklama nie działa?
Nie. Wynik może być rzeczywiście bliski zeru albo test może mieć zbyt małą moc. Trzeba odczytać przedział niepewności i porównać go z efektem istotnym biznesowo.
Czy można zmieniać kampanię podczas testu?
Niewielkie działania operacyjne mogą być dopuszczalne, ale istotna zmiana budżetu, celu, kreacji lub populacji zmienia badaną interwencję. Zasady należy ustalić przed startem i dokumentować.
Jak długo powinien trwać test?
Powinien objąć pełny rytm sprzedaży i czas konwersji oraz zgromadzić próbę potrzebną do decyzji. Długość wynika z bazy, oczekiwanego efektu i zmienności, nie z jednej uniwersalnej liczby dni.
Czy test geograficzny jest gorszy od użytkownikowego?
Nie, odpowiada innym warunkom. Może mierzyć media i sprzedaż trudne do podziału na użytkowników, ale wymaga dobrego doboru regionów, danych historycznych oraz kontroli lokalnych zakłóceń.