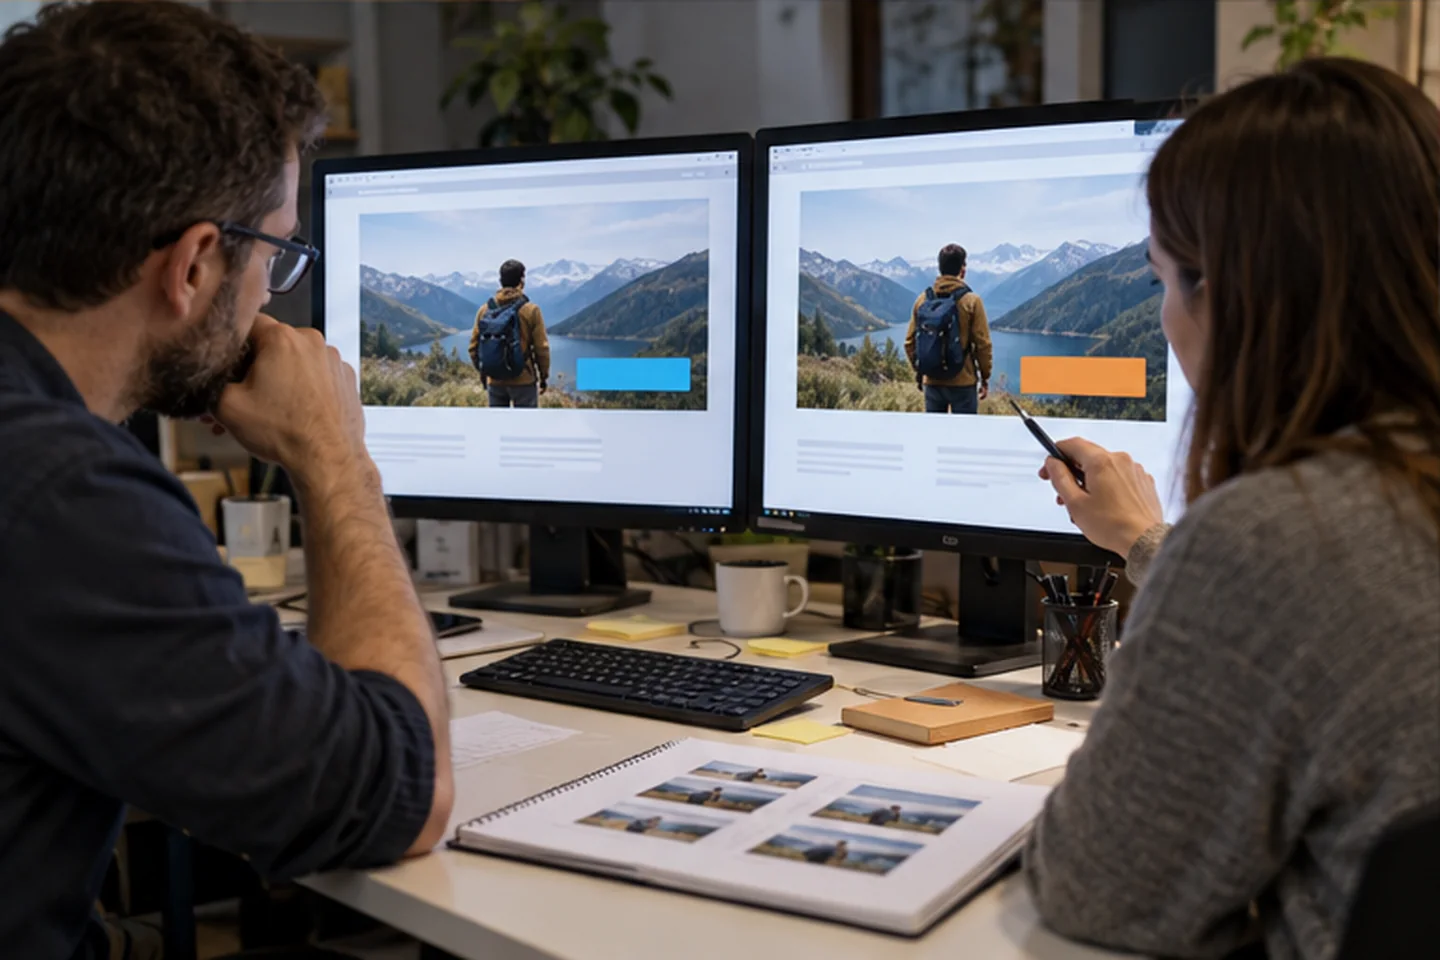
Test A/B nie polega na uruchomieniu dwóch reklam i wybraniu tej, która po kilku godzinach ma lepszy wynik. Jest zaplanowanym porównaniem jednej hipotezy przy możliwie równych warunkach. Jeśli warianty różnią się nagłówkiem, grafiką, ofertą i grupą, wynik nie pokaże, która decyzja miała znaczenie.
Przed startem trzeba zapisać miernik, jednostkę analizy, minimalny okres, regułę zakończenia i działanie po wyniku. Dzięki temu zespół nie zatrzymuje eksperymentu w wygodnym momencie ani nie wybiera po fakcie wskaźnika, który wygląda korzystnie.
Zapisz hipotezę jako mechanizm, nie życzenie
Dobra hipoteza łączy zmianę, odbiorcę, oczekiwane zachowanie i powód. „Nowy przycisk zwiększy konwersję” jest słabe. Lepsza wersja wskazuje, że konkretna nazwa kolejnego kroku zmniejszy niepewność nowych użytkowników i zwiększy ukończone formularze bez pogorszenia jakości leadów.
Hipoteza powinna wynikać z danych, badania lub obserwacji. Mapy kliknięć, rozmowy, analiza formularza i pytania klientów mogą wskazać problem. Test bez przesłanki również dostarcza wynik, ale trudniej przenieść wiedzę na kolejną sytuację.
Warto określić, co pozostaje stałe: grupa, placement, oferta, strona, czas i sposób optymalizacji. W systemach reklamowych algorytm może różnie dostarczać warianty, dlatego trzeba poznać mechanizm testu platformy oraz możliwość równomiernego podziału.
Zmiana powinna być wystarczająco istotna, aby reprezentować hipotezę. Dwa prawie identyczne odcienie przycisku rzadko odpowiadają ważnemu problemowi biznesowemu. Z kolei całkowicie różne koncepcje można porównać, ale wniosek będzie dotyczył całych pakietów, nie pojedynczego elementu.
Karta testu przed uruchomieniem
- problem, źródło obserwacji i dokładna hipoteza;
- wariant kontrolny, zmiana i elementy stałe;
- miernik główny, wskaźniki ochronne i definicje;
- jednostka przydziału oraz sposób uniknięcia mieszania;
- minimalny okres, potrzebny wolumen i reguła zakończenia;
- decyzja dla wygranej, braku różnicy i wyniku sprzecznego.
Dobierz jednostkę, miernik i czas do decyzji
Jednostką może być użytkownik, sesja, gospodarstwo, region lub inny obiekt. Ten sam użytkownik nie powinien przypadkowo widzieć obu wariantów, jeśli doświadczenie jednego wpływa na drugi. Przy testach e-mailowych czy lokalnych trzeba również uważać na kontakt między grupami.
Miernik główny odpowiada hipotezie. Jeśli zmiana dotyczy formularza, liczy się ukończenie i jakość kontaktu, nie samo kliknięcie w przycisk. Wskaźniki ochronne sprawdzają, czy poprawa nie zwiększa rezygnacji, reklamacji, zwrotów lub czasu obsługi.
Minimalny okres powinien objąć naturalny rytm tygodnia, kampanii i opóźnienia. Zakończenie po pierwszym dniu może premiować przypadkową grupę lub efekt nowości. Zbyt długie prowadzenie testu przy oczywistej awarii jest jednak niepotrzebne. Reguły techniczne i statystyczne muszą być ustalone wcześniej.
Wymagana liczba zdarzeń zależy od bazowego poziomu, minimalnej istotnej różnicy, zmienności i przyjętej metody. Nie powinno się ustalać jej jedną uniwersalną tabelą bez danych. Przy małym ruchu test ilościowy może trwać zbyt długo; wtedy lepiej najpierw wykonać badanie jakościowe lub większą zmianę.
Definicje powinny być zgodne z KPI kampanii. Jeśli system kanału liczy konwersję inaczej niż CRM, test może wskazać wariant generujący więcej zgłoszeń, ale mniej dobrych klientów. Wynik końcowy trzeba sprawdzić w odpowiednim źródle.
| Ryzyko | Objaw | Działanie |
|---|---|---|
| przedwczesne zakończenie | wielokrotne sprawdzanie i stop przy korzystnym wyniku | reguła zakończenia zapisana przed startem |
| mieszanie wariantów | użytkownik widzi A i B w jednej decyzji | stały przydział oraz kontrola identyfikatora |
| zmiana warunków | promocja lub awaria tylko w części testu | oznaczenie okresu i ocena reprezentatywności |
| wiele mierników | wybór po fakcie najlepszego wyniku | jeden główny i wcześniej zapisane ochronne |
Uruchom warianty z kontrolą techniczną i biznesową
Przed emisją oba warianty przechodzą ten sam test linku, urządzenia, szybkości, formularza, analityki i systemu końcowego. Błąd w jednym wariancie nie jest dowodem jego słabszej perswazji. Jeśli testujemy właśnie aspekt techniczny, powinien być świadomie częścią hipotezy.
Podział ruchu trzeba monitorować pod kątem grupy, urządzenia, dnia i źródła. Nierówna liczba nie zawsze jest błędem, ale system powinien wyjaśniać metodę. Algorytm optymalizujący emisję może szybko faworyzować wariant, przez co porównanie przestaje być losowe.
W trakcie testu nie należy zmieniać treści jednego wariantu bez wersjonowania. Jeżeli wykryto błąd wymagający poprawy, trzeba zdecydować, czy restartować okres. Połączenie danych sprzed i po zmianie może fałszować wniosek.
Równoległe kampanie, kody rabatowe i zmiana ceny mogą wpływać na obie grupy lub tylko jedną. Kalendarz zdarzeń pomaga interpretować wynik. Jeśli zewnętrzne zakłócenie jest duże, uczciwym wnioskiem może być powtórzenie testu zamiast wymuszania odpowiedzi.
Test na landing page powinien zachować zgodność z reklamą. Wariant nagłówka dopasowany do innej grupy może wymagać osobnej kampanii, a nie losowego mieszania wszystkich użytkowników. Jedność doświadczenia jest ważniejsza niż wygoda jednego eksperymentu.
Oddziel wynik statystyczny od decyzji biznesowej
Brak wykrytej różnicy nie dowodzi, że warianty są identyczne. Test mógł nie mieć wystarczającej mocy albo różnica być mniejsza niż potrzebna. Należy podać zakres niepewności i minimalny efekt, dla którego test zaprojektowano.
Wynik istotny statystycznie nie musi być opłacalny. Niewielki wzrost konwersji może nie uzasadniać kosztu produkcji, utrzymania czy ryzyka dla marki. Decyzja powinna uwzględniać wielkość efektu, marżę, jakość i możliwość skalowania.
Trzeba sprawdzić segmenty, ale nie poszukiwać bez końca grupy, w której pojawi się korzystny wynik. Analiza segmentowa powinna wynikać z wcześniejszej hipotezy albo być oznaczona jako eksploracyjna do potwierdzenia w następnym teście.
Wariant wygrywający przy małym budżecie może zachować się inaczej po skali. Zmienia się częstotliwość, grupa oraz placement. Wdrożenie należy monitorować, a wynik testu przechowywać z warunkami. Nie jest wieczną zasadą dla wszystkich kampanii.
Wnioski warto wpisać do biblioteki: hipoteza, wersje, zrzuty, definicje, okres, wyniki, zakłócenia i decyzja. Pozwala to uniknąć powtarzania testu oraz ocenić, czy zasada działa w innych kontekstach. Sam wpis „B wygrało” jest bezużyteczny po kilku miesiącach.
Jeśli wynik dotyczy kanału, trzeba uważać na model atrybucji. Dwa warianty mogą mieć podobne zachowanie na stronie, ale różnić się raportowaną konwersją przez okno lub identyfikację. Wspólny system końcowy zmniejsza to ryzyko.
Po serii testów zespół powinien przeglądać, czy optymalizacja lokalna nie pogorszyła spójności marki. Nagłówki wygrywające krótkoterminowe kliknięcie mogą stopniowo przesunąć obietnicę. Poradnik o spójności pomaga zachować warunki brzegowe.
W testach cen i promocji szczególne znaczenie mają uczciwość, wpływ na klientów oraz możliwość spełnienia oferty. Różne ceny dla przypadkowych grup mogą stworzyć ryzyko reputacyjne i wymagają oceny prawnej oraz biznesowej. Nie każdy element, który da się technicznie zmienić, powinien być przedmiotem eksperymentu.
Testowanie komunikatu o bezpieczeństwie, zgodzie lub warunkach nie może polegać na ukrywaniu informacji w wariancie. Celem może być poprawa zrozumienia, ale minimalny zakres pozostaje warunkiem. Wskaźnik kliknięcia nie ma pierwszeństwa przed świadomą decyzją odbiorcy.
W eksperymencie geograficznym obszary powinny być podobne, a przepływ ludzi i mediów między nimi ograniczony lub uwzględniony. Kampania ogólnokrajowa, rozgłos i różnice dostępności mogą zanieczyścić porównanie. Plan powinien opisać te czynniki przed analizą.
W testach e-mailowych znaczenie ma dostarczalność, pora i lista. Inny temat wysłany w innym czasie nie jest czystym porównaniem. Miernik otwarcia może być niepełny z powodów technicznych, dlatego ważniejsze bywają kliknięcia, odpowiedzi lub działania końcowe.
Wariant kontrolny powinien być aktualnym doświadczeniem, a nie celowo słabą wersją. Sztuczne stworzenie gorszego A zawyża wartość nowego pomysłu i nie daje wiedzy. Kontrola musi również działać poprawnie technicznie przez cały okres.
Jeśli wiele zespołów prowadzi testy na tej samej stronie, eksperymenty mogą na siebie wpływać. Potrzebny jest rejestr, priorytety i informacja o nakładaniu. Jednoczesna zmiana ceny w jednym teście i formularza w drugim utrudnia interpretację obu.
Automatyczne systemy wielowariantowe optymalizują ruch w trakcie, co może być użyteczne biznesowo, ale różni się od stałego eksperymentu A/B. Raport powinien wyjaśniać algorytm i nie porównywać surowych współczynników tak, jakby grupy miały równy, losowy przydział.
Najczęstsze pytania o testy A/B reklamy
Jak długo powinien trwać test?
Zależy od wolumenu, bazowego wyniku, oczekiwanego efektu i cyklu tygodnia. Okres oraz regułę zakończenia należy ustalić przed startem, nie po zobaczeniu korzystnej różnicy.
Czy można testować kilka elementów naraz?
Można porównać całe koncepcje, ale wniosek dotyczy wtedy pakietu. Jeśli celem jest poznanie wpływu elementu, pozostałe warunki powinny pozostać stałe.
Co oznacza brak zwycięzcy?
Że w danych i przy przyjętej metodzie nie wykryto wystarczającej różnicy. Nie oznacza pełnej równości. Można zachować prostszy wariant, zebrać więcej danych lub zaprojektować mocniejszą hipotezę.
Czy wygrywający wariant wdrażać od razu?
Po kontroli jakości, wielkości efektu, kosztu i wskaźników ochronnych. Przy dużym ryzyku warto wdrażać etapami i monitorować wynik po skalowaniu.
Czy platformowy eksperyment wystarczy?
Może zapewnić podział ruchu, ale nadal trzeba sprawdzić definicję, optymalizację, atrybucję i wynik biznesowy. Narzędzie nie zastępuje hipotezy ani interpretacji.
Źródła i rzetelne eksperymentowanie
Eksperyment nie usprawiedliwia mylącej oferty ani nieczytelnych warunków. Informacje o prawach konsumentów i zasadach rynkowych publikuje Urząd Ochrony Konkurencji i Konsumentów. Sposób przetwarzania danych i konfiguracji testu należy dostosować do aktualnych wymagań.